
Con la adopción de modelos generativos aparece una pregunta cada vez más frecuente en empresas y equipos de tecnología:
¿Conviene ejecutar nuestros propios modelos o consumir inteligencia artificial como servicio?
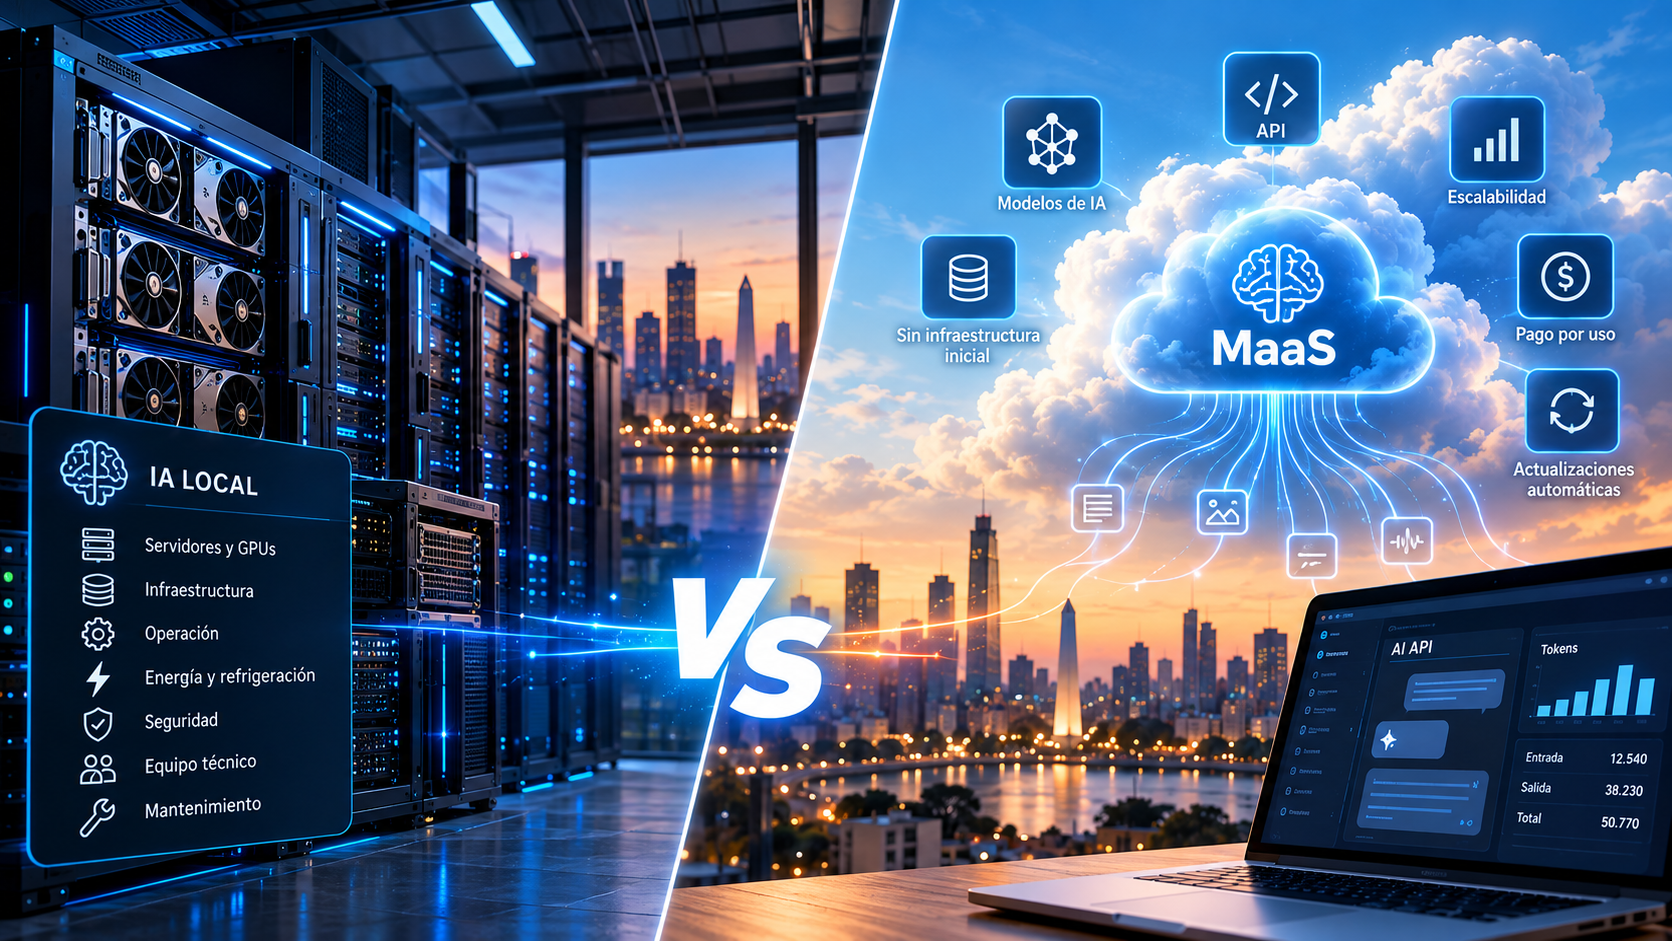
Por un lado tenemos modelos que pueden ejecutarse sobre infraestructura propia, servidores dedicados o GPUs contratadas en cloud.
Por el otro, existen servicios que permiten consumir modelos mediante API y pagar según el uso, sin administrar directamente toda la infraestructura necesaria para ejecutarlos.
A primera vista la comparación parece sencilla:
¿Cuánto cuesta una GPU frente a cuánto cuesta consumir un modelo por tokens?
El problema es que esa comparación deja afuera buena parte del costo real.
Para decidir correctamente hay que mirar infraestructura, utilización, operación, escalabilidad, privacidad, calidad del modelo y, sobre todo, cuánto cuesta obtener un resultado útil para el negocio.
La discusión se parece bastante a cloud vs infraestructura propia
Durante años discutimos si determinados workloads debían ejecutarse sobre infraestructura propia o consumirse desde cloud.
Con inteligencia artificial está ocurriendo algo parecido, pero aparecen nuevas unidades económicas.
Ya no hablamos solamente de CPU, memoria y almacenamiento.
Ahora entran en juego variables como GPU, memoria de GPU, tokens de entrada y salida, contexto, caching, concurrencia, throughput, latencia, almacenamiento de modelos, bases vectoriales y observabilidad.
Esto vuelve más compleja la comparación porque el gasto puede quedar distribuido entre diferentes capas: infraestructura, cloud, proveedores de modelos, plataformas especializadas, datos y operación.
Controlar el costo de IA, por lo tanto, no consiste simplemente en mirar la factura de una API.
¿Qué significa realmente ejecutar IA “local”?
Cuando hablamos de IA local o self-hosted no necesariamente hablamos de una GPU dentro de una oficina.
Un modelo puede ejecutarse sobre infraestructura propia, servidores dedicados, GPUs alquiladas o incluso infraestructura cloud administrada por la organización.
Lo que cambia es la responsabilidad.
Cuando gestionamos nosotros mismos la inferencia también tenemos que tomar decisiones sobre:
- Hardware y GPUs.
- Memoria disponible.
- Runtime de inferencia.
- Escalabilidad.
- Alta disponibilidad.
- Almacenamiento de modelos.
- Monitoreo.
- Seguridad.
- Actualizaciones.
- Capacidad operativa.
Las herramientas actuales simplifican mucho este trabajo, pero la infraestructura sigue existiendo y alguien tiene que operarla.
MaaS mueve parte de esa complejidad hacia el proveedor
En un esquema Model as a Service o MaaS, la organización consume un modelo mediante una API.
El proveedor se ocupa de buena parte de la infraestructura necesaria para servir ese modelo.
Esto permite experimentar, prototipar y desplegar productos rápidamente sin tener que construir primero una plataforma completa de inferencia.
A cambio, aparece una economía basada en consumo.
Dependiendo del proveedor y del servicio pueden existir costos asociados a:
- Tokens de entrada.
- Tokens de salida.
- Contexto.
- Entrada cacheada.
- Procesamiento batch.
- Capacidad provisionada.
- Fine-tuning.
- Almacenamiento.
- Herramientas adicionales.
Por eso tampoco existe un único “precio de usar IA”.
Existe el precio de nuestro patrón particular de uso.
El error de comparar solamente tokens contra GPU
Supongamos que una GPU ejecutando un modelo abierto puede producir inferencia a un costo teórico menor que una API comercial.
Eso todavía no demuestra que self-hosting sea más económico.
Hay una variable fundamental:
¿Cuánto vamos a utilizar realmente esa infraestructura?
Una GPU propia genera costo incluso cuando está esperando requests.
Si necesitamos capacidad adicional para picos, redundancia o alta disponibilidad, también hay que contemplarla.
Lo mismo ocurre si necesitamos varias GPUs para ejecutar modelos grandes o alcanzar determinado throughput.
Una plataforma con alta utilización sostenida puede distribuir muy bien su costo fijo.
Una plataforma con demanda baja o impredecible puede terminar manteniendo infraestructura costosa durante muchas horas sin utilizarla.
El costo real de IA tiene varias capas
El modelo es solamente una parte de la solución.
Dependiendo de la arquitectura, el costo total puede incluir:
- Modelo: licencia, proveedor o condiciones de uso.
- Compute: GPU, CPU y memoria.
- Datos: almacenamiento, bases vectoriales y pipelines.
- Red: transferencia y comunicación entre servicios.
- Operación: despliegue, mantenimiento y actualizaciones.
- Observabilidad: métricas, logs, tracing y evaluación.
- Seguridad: accesos, secretos, aislamiento y controles.
- Personas: ingeniería, plataforma y soporte.
Por eso una comparación económica seria debería mirar el sistema completo y no solamente el componente más visible.
MaaS también puede desperdiciar mucho dinero
Consumir una API tampoco garantiza eficiencia.
Existen varios patrones que pueden aumentar el gasto sin aportar demasiado valor.
- Utilizar modelos demasiado grandes para tareas simples.
- Enviar contextos enormes en cada request.
- Generar respuestas más largas de lo necesario.
- No aprovechar caching cuando está disponible.
- Repetir información en cada llamada.
- Diseñar agentes que realizan llamadas innecesarias.
- No medir reintentos o requests duplicados.
- Utilizar modelos premium para tareas que podrían resolver modelos más pequeños.
Un prototipo puede costar muy poco y, después de ganar usuarios, transformar rápidamente el consumo de IA en uno de los costos relevantes del producto.
La facilidad para comenzar es justamente una de las razones por las que conviene incorporar medición desde temprano.
Privacidad: local no significa automáticamente seguro
La privacidad suele aparecer como uno de los principales argumentos para ejecutar modelos internamente.
Y en determinados escenarios puede ser una razón completamente válida.
Pero conviene evitar simplificaciones.
Un modelo local mal protegido también puede exponer información sensible.
Y un servicio gestionado puede ofrecer distintos niveles de aislamiento, regiones de procesamiento, controles empresariales y condiciones contractuales.
La decisión debería analizar requisitos concretos:
- Clasificación de la información.
- Residencia de datos.
- Retención.
- Contratos.
- Regulación.
- Auditoría.
- Controles de acceso.
- Dependencia del proveedor.
La pregunta útil no es solamente “¿sale de nuestra infraestructura?”.
La pregunta es qué nivel de control y protección necesita realmente ese dato.
La calidad del resultado también forma parte del costo
Hay otra variable que muchas comparaciones económicas dejan afuera: la calidad.
Un modelo más económico no sirve de mucho si requiere repetir tareas, genera resultados incorrectos o necesita intervención humana constante.
Por eso comparar solamente costo por token puede ser insuficiente.
Una métrica mucho más interesante es:
costo por resultado útil.
Según el caso de uso, eso puede transformarse en:
- Costo por documento procesado.
- Costo por ticket resuelto.
- Costo por consulta respondida.
- Costo por transacción analizada.
- Costo por tarea completada.
- Costo por usuario activo.
Ahí empezamos a relacionar infraestructura y consumo con valor para el negocio.
Y ahí empieza a aparecer claramente FinOps aplicado a IA.
¿Cuándo puede tener sentido ejecutar modelos propios?
Self-hosting puede resultar especialmente interesante cuando existe una combinación de factores como:
- Volumen importante y relativamente estable.
- Alta utilización de infraestructura.
- Necesidad fuerte de control.
- Modelos abiertos que funcionan bien para el caso de uso.
- Requisitos específicos de latencia.
- Capacidad técnica para operar la plataforma.
- Necesidad de personalización profunda.
- Infraestructura existente que puede aprovecharse.
En esas condiciones, distribuir el costo de infraestructura entre grandes volúmenes de inferencia puede resultar atractivo.
¿Cuándo puede tener más sentido MaaS?
Consumir modelos como servicio suele ser atractivo cuando:
- El volumen todavía es incierto.
- Queremos experimentar rápidamente.
- Necesitamos acceder a distintos modelos.
- La demanda cambia mucho.
- No queremos operar infraestructura GPU.
- El tiempo de salida al mercado es prioritario.
- Necesitamos escalar sin comprar capacidad anticipadamente.
En esos escenarios, pagar por consumo puede tener más sentido que construir una plataforma antes de saber cuánto se utilizará.
La respuesta también puede ser híbrida
No todas las aplicaciones necesitan elegir un único modelo de operación.
Una organización puede ejecutar internamente modelos pequeños o especializados y utilizar modelos externos más potentes para determinadas tareas.
Incluso una misma aplicación puede utilizar routing.
- Solicitudes simples hacia modelos más económicos.
- Problemas complejos hacia modelos más capaces.
- Datos sensibles hacia infraestructura controlada.
- Procesos batch hacia opciones de menor costo.
- Picos de demanda hacia servicios externos.
La arquitectura deja entonces de ser “local o API” y pasa a convertirse en un problema de routing entre costo, calidad, privacidad y rendimiento.
Cómo comparar escenarios sin adivinar
Antes de tomar una decisión conviene medir o estimar variables concretas.
- Requests por día.
- Tokens promedio por request.
- Tokens de salida.
- Concurrencia.
- Horarios de mayor demanda.
- Latencia objetivo.
- Modelo requerido.
- Calidad mínima aceptable.
- Utilización esperada de GPU.
- Necesidad de alta disponibilidad.
- Costo de operación.
- Necesidad de observabilidad.
Con esos datos podemos construir distintos escenarios y comparar cómo se comportan a medida que aumenta el uso.
No existe un ganador universal
Ejecutar modelos propios no es automáticamente más barato.
Consumir una API tampoco.
La decisión depende de volumen, utilización, calidad, privacidad, capacidad operativa y arquitectura.
Por eso la pregunta más útil no es:
“¿Cuál modelo cuesta menos?”
Sino:
¿Cuánto nos cuesta producir el resultado que necesitamos con el nivel de calidad, control y rendimiento que necesitamos?
La inteligencia artificial introduce nuevas tecnologías, pero no elimina la economía de infraestructura.
Simplemente introduce nuevas unidades de consumo.
Y ahí FinOps tiene un rol cada vez más importante.
Preguntas frecuentes
¿Ejecutar IA local siempre es más barato?
No. Depende de la utilización de la infraestructura, el modelo elegido, la operación, el volumen de inferencia y los requisitos de disponibilidad.
¿Qué significa MaaS?
MaaS significa Model as a Service. Es un modelo en el que una organización consume modelos de inteligencia artificial como servicio, normalmente mediante API, sin administrar directamente toda la infraestructura que los ejecuta.
¿Qué métrica conviene mirar para controlar costos de IA?
Además de tokens, infraestructura y requests, conviene relacionar el gasto con una unidad de valor: por ejemplo costo por documento procesado, ticket resuelto o tarea completada.
¿Estás evaluando cómo implementar IA sin perder control sobre los costos?
Antes de elegir una arquitectura conviene comparar escenarios de consumo, infraestructura, operación y crecimiento esperado.
En FinOps Argentina analizamos estos escenarios para entender cuánto cuesta realmente cada alternativa y cómo se comportaría a medida que el uso crece.